← Все лекции

Открытый интернет после LLM и агентов. Как теперь устроен поиск в интернете для тех, кто в нем ищет и для тех, кто хочет, чтобы вас нашли

о чем этот цикл

Мы много говорим про модели и агентов — и незаслуженно мало о том, как из-за ИИ меняется сам интернет. А он меняется на глазах: привычные поисковые индексы закрываются, на смену им приходят инструменты с другой, не всегда прозрачной архитектурой. Вырастает параллельный веб — веб для агентов, в котором мы впервые за двадцать лет перестали быть основным пользователем.

Этот цикл — о том, как разобраться в переходе: от того, как веб-поиск был устроен раньше, до того, что агенты теперь делают в вебе, — и что из этого следует для инструментов, рабочих сборок и SEO.

Смотреть можно в любом порядке и добирать объяснения там, где непонятно. Задача цикла — дать долговременный фундамент и ментальные модели, соединив теорию с практикой.

для кого

Если вы хотите, чтобы вас находили

  • Поисковый трафик упал, хотя позиции по ключевым словам на месте, и непонятно, где потерялись люди
  • Вам предлагают подписку на трекер AI-видимости, и вы не понимаете, что именно он измеряет и стоит ли это своих денег
  • Вы отвечаете за упоминания бренда и хотите понимать, как они теперь превращаются в видимость у моделей — и почему стали весить больше, чем ссылки
  • Вы заказываете SEO на подряде и хотите отличать осмысленное предложение от пустого обещания
Трек «Инфраструктура и видимость»

Если вы ищете с ИИ сами — от аутрича до исследований

  • Вам принципиально понимать, как именно LLM и агенты находят информацию в интернете, и чем отличаются ChatGPT, Claude, Gemini, Perplexity и другие
  • Вы делаете исследование через ИИ, и на вопрос «откуда эта цифра» нужно знать достоверный ответ
  • Вам нужно то, чего обычный поиск не достает: свежее до индексации, спрятанное за формой или пагинацией, лежащее в научной или отраслевой базе
  • Вы собираете информацию о компаниях, людях или возможностях, и цена ошибки в этих данных измеряется деньгами
Трек «Инфраструктура и сборки»

Если вы собираете системы или внедряете ИИ в команде

  • Вопросы про инструменты прилетают к вам быстрее, чем вы успеваете в них разобраться
  • Вы хотите досконально разобраться в том, как изменился открытый интернет, и пересобрать стек относительно этих изменений
  • У вас есть опыт исследований с LLM и агентами, но вы испытываете трудности с валидацией
Трек «Инфраструктура + видимость + сборки»

о лекторе

Ангелина Зайцева

Ангелина Зайцева

исследовательница, основательница Digital Garden · gardenresearch.eu

Работает с поисковыми системами и SEO, строит и консультирует в поле ИИ для исследований. Четыре года отвечала за SEO-оптимизацию и маркетинг международной студии стратегического брендинга Bolder — к 2026 году канал из нулевого превратился в ключевой канал привлечения новых клиентов.

В рамках магистерской диссертации ставила эксперименты над Exa и Parallel. Преподает в Constructor University, Германия.

Три трека: что внутри

Инфраструктура и видимость

маркетинг, PR, SEO

  • 1Как устроен веб-поиск

    База, без которой не видно, что изменилось: как устроены классический веб-поиск, кроулинг и индексирование.

    Что усвоим: как устроены классический веб-поиск, кроулинг и индексирование

  • 2LLM-поиск, Deep Research и агентный поиск

    Дотошно разбираем встроенный веб-поиск ChatGPT, Gemini, Claude и Perplexity: как и куда они ходят, почему — и что система видит при поиске, но не всегда показывает вам. Так же подробно — режимы Deep Research и агентный поиск.

    Что усвоим: куда ходит каждая из четырех систем и что она видит, но не показывает

  • 7SEO: что теперь измеряется и кто этим занимается

    Что теперь можно измерять, во что превратилась профессия сеошника и на что смотреть, если вы работаете с SEO — сами или через подряд. Отдельный блок — как сейчас работают трекеры AI-visibility и что там принципиально можно и нельзя увидеть.

    Что усвоим: как читать трекеры AI-видимости и предложения подрядчиков — что там измеримо, а что продается как измеримое
21 000 ₽ 16 000 ₽

Цена до 10 сентября

Купить

Инфраструктура и сборки

исследования, аутрич, внедрение ИИ

  • 1Как устроен веб-поиск

    База, без которой не видно, что изменилось: как устроены классический веб-поиск, кроулинг и индексирование.

    Что усвоим: как устроены классический веб-поиск, кроулинг и индексирование

  • 2LLM-поиск, Deep Research и агентный поиск

    Дотошно разбираем встроенный веб-поиск ChatGPT, Gemini, Claude и Perplexity: как и куда они ходят, почему — и что система видит при поиске, но не всегда показывает вам. Так же подробно — режимы Deep Research и агентный поиск.

    Что усвоим: куда ходит каждая из четырех систем и что она видит, но не показывает

  • 3Работы агентов в интернете по JTBD и инструменты

    Работа агентов в открытом вебе через методику Jobs To Be Done: что агенты теперь делают в вебе и какие инструменты какие задачи уже решают. На атомы разбираем архитектуры новых инструментов — Exa, Parallel, Firecrawl, Newscatcher и Valyu, — чтобы с толком делегировать им задачи.

    Что усвоим: какой инструмент брать под задачу — кто достает свежее, кто спрятанное за формой, кто научное

  • 4Сборки и агенты

    Тонкости самих сборок: workflows против агентских. Типовые сборки на живых примерах: дайджесты, B2B-поиск и обогащение данных, автоматика для подготовки к интервью и звонкам, поиск грантов и funding opportunities.

    Что усвоим: где хватает пайплайна, а где нужен агент, и за что здесь платят зря

  • 5API vs. MCP

    Разница подключения через API и через MCP — и почему ни в коем случае не нужно втыкать все MCP в мире.

    Что усвоим: что подключать через API, а что через MCP

  • 6Демо

    Одну и ту же задачу — мониторинг интернета — решаем тремя способами: чатом, пайплайном в n8n и агентом. На живом примере видно, чем они отличаются.

    Что усвоим: чем на одной задаче различаются чат, пайплайн в n8n и агент

21 000 ₽ 16 000 ₽

Цена до 10 сентября

Купить

Инфраструктура + видимость + сборки

маркетинг, PR, SEO, исследования, аутрич, внедрение ИИ

  • 1Как устроен веб-поиск

    База, без которой не видно, что изменилось: как устроены классический веб-поиск, кроулинг и индексирование.

    Что усвоим: как устроены классический веб-поиск, кроулинг и индексирование

  • 2LLM-поиск, Deep Research и агентный поиск

    Дотошно разбираем встроенный веб-поиск ChatGPT, Gemini, Claude и Perplexity: как и куда они ходят, почему — и что система видит при поиске, но не всегда показывает вам. Так же подробно — режимы Deep Research и агентный поиск.

    Что усвоим: куда ходит каждая из четырех систем и что она видит, но не показывает

  • 3Работы агентов в интернете по JTBD и инструменты

    Работа агентов в открытом вебе через методику Jobs To Be Done: что агенты теперь делают в вебе и какие инструменты какие задачи уже решают. На атомы разбираем архитектуры новых инструментов — Exa, Parallel, Firecrawl, Newscatcher и Valyu, — чтобы с толком делегировать им задачи.

    Что усвоим: какой инструмент брать под задачу — кто достает свежее, кто спрятанное за формой, кто научное

  • 4Сборки и агенты

    Тонкости самих сборок: workflows против агентских. Типовые сборки на живых примерах: дайджесты, B2B-поиск и обогащение данных, автоматика для подготовки к интервью и звонкам, поиск грантов и funding opportunities.

    Что усвоим: где хватает пайплайна, а где нужен агент, и за что здесь платят зря

  • 5API vs. MCP

    Разница подключения через API и через MCP — и почему ни в коем случае не нужно втыкать все MCP в мире.

    Что усвоим: что подключать через API, а что через MCP

  • 6Демо

    Одну и ту же задачу — мониторинг интернета — решаем тремя способами: чатом, пайплайном в n8n и агентом. На живом примере видно, чем они отличаются.

    Что усвоим: чем на одной задаче различаются чат, пайплайн в n8n и агент

  • 7SEO: что теперь измеряется и кто этим занимается

    Что теперь можно измерять, во что превратилась профессия сеошника и на что смотреть, если вы работаете с SEO — сами или через подряд. Отдельный блок — как сейчас работают трекеры AI-visibility и что там принципиально можно и нельзя увидеть.

    Что усвоим: как читать трекеры AI-видимости и предложения подрядчиков — что там измеримо, а что продается как измеримое
28 000 ₽ 21 000 ₽

Цена до 10 сентября

Купить

Первая часть уже доступна на YouTube

Разбираемся, как устроены классический поиск в интернете, кроулинг и индексирование — чтобы понять, что именно изменилось и почему.

формат

Лекции в записи

Можно смотреть в любом порядке и возвращаться к нужной части. Всего ≈ 5 часов.

Интерактивные слайды

К каждой части есть слайды в формате веб-страницы — удобно для самостоятельного изучения.

Удобный личный кабинет

Лекции и слайды живут в кабинете: открываются вашим входом через Telegram.

программа

часть 1 → 42 мин

Как устроен веб-поиск

База, без которой не видно, что изменилось: как устроены классический веб-поиск, кроулинг и индексирование.

бесплатно

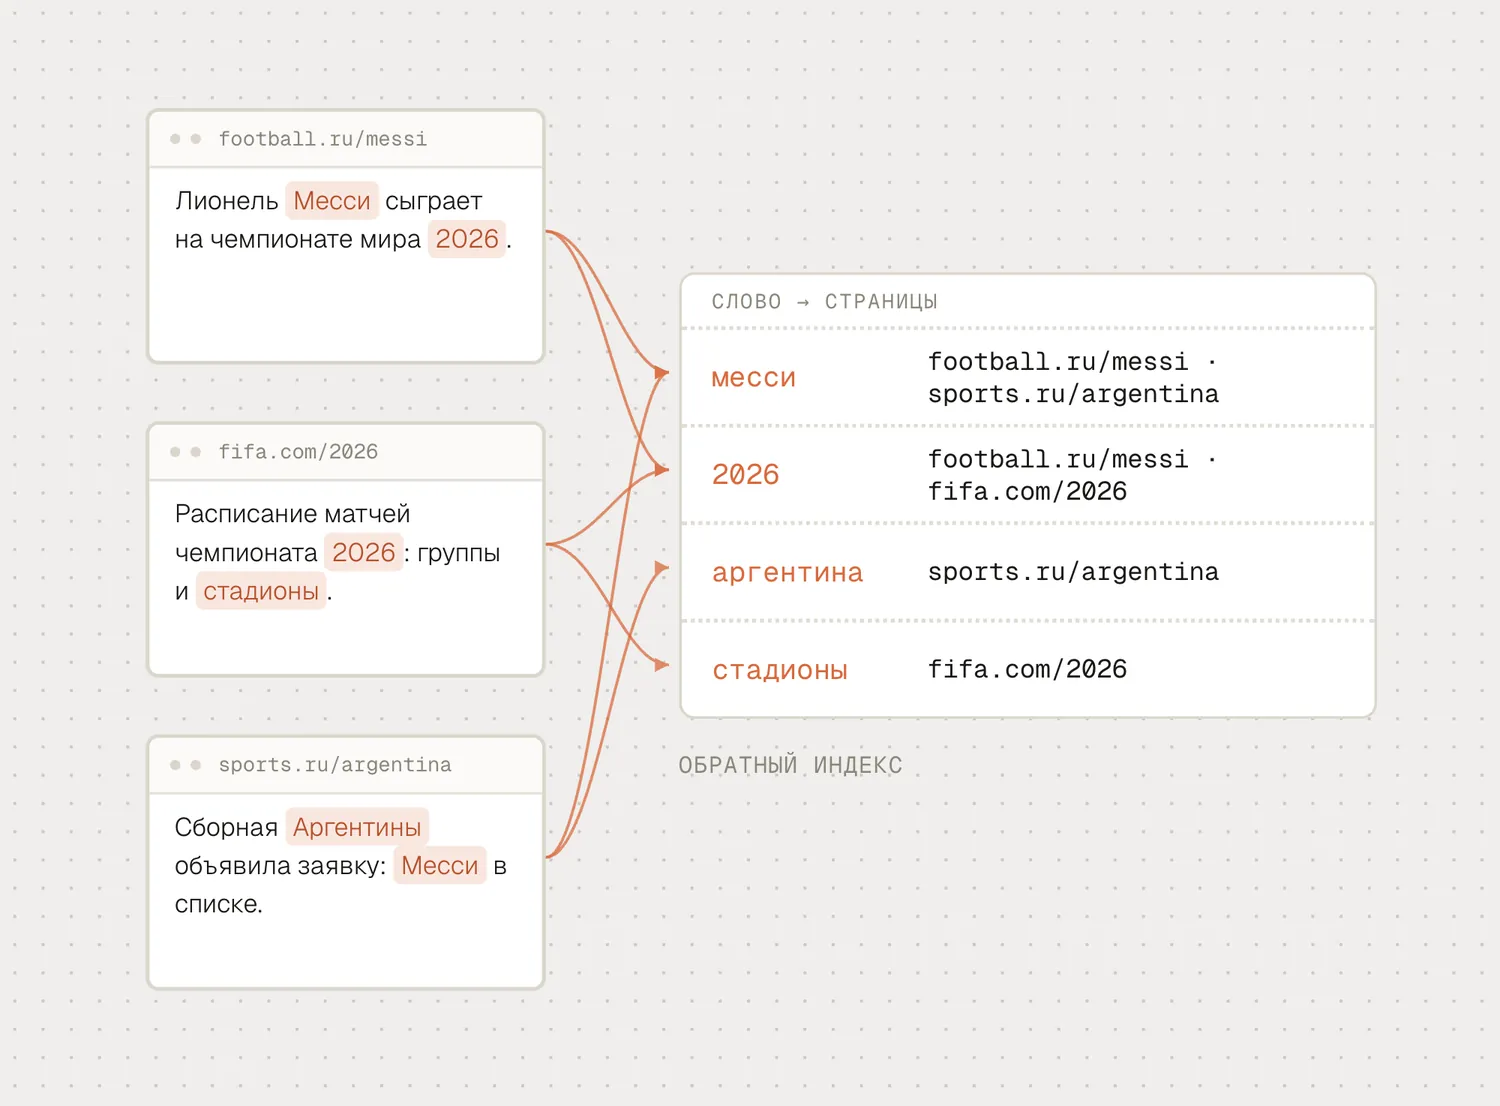
Схема обратного индекса: три страницы, разобранные на слова, и таблица, в которой от каждого слова идут ссылки на страницы, где оно встречается

часть 2 → 54 мин

LLM-поиск, Deep Research и агентный поиск

Дотошно разбираем встроенный веб-поиск ChatGPT, Gemini, Claude и Perplexity: как и куда они ходят, почему — и что система видит при поиске, но не всегда показывает вам. Так же подробно — режимы Deep Research и агентный поиск.

видимость сборки

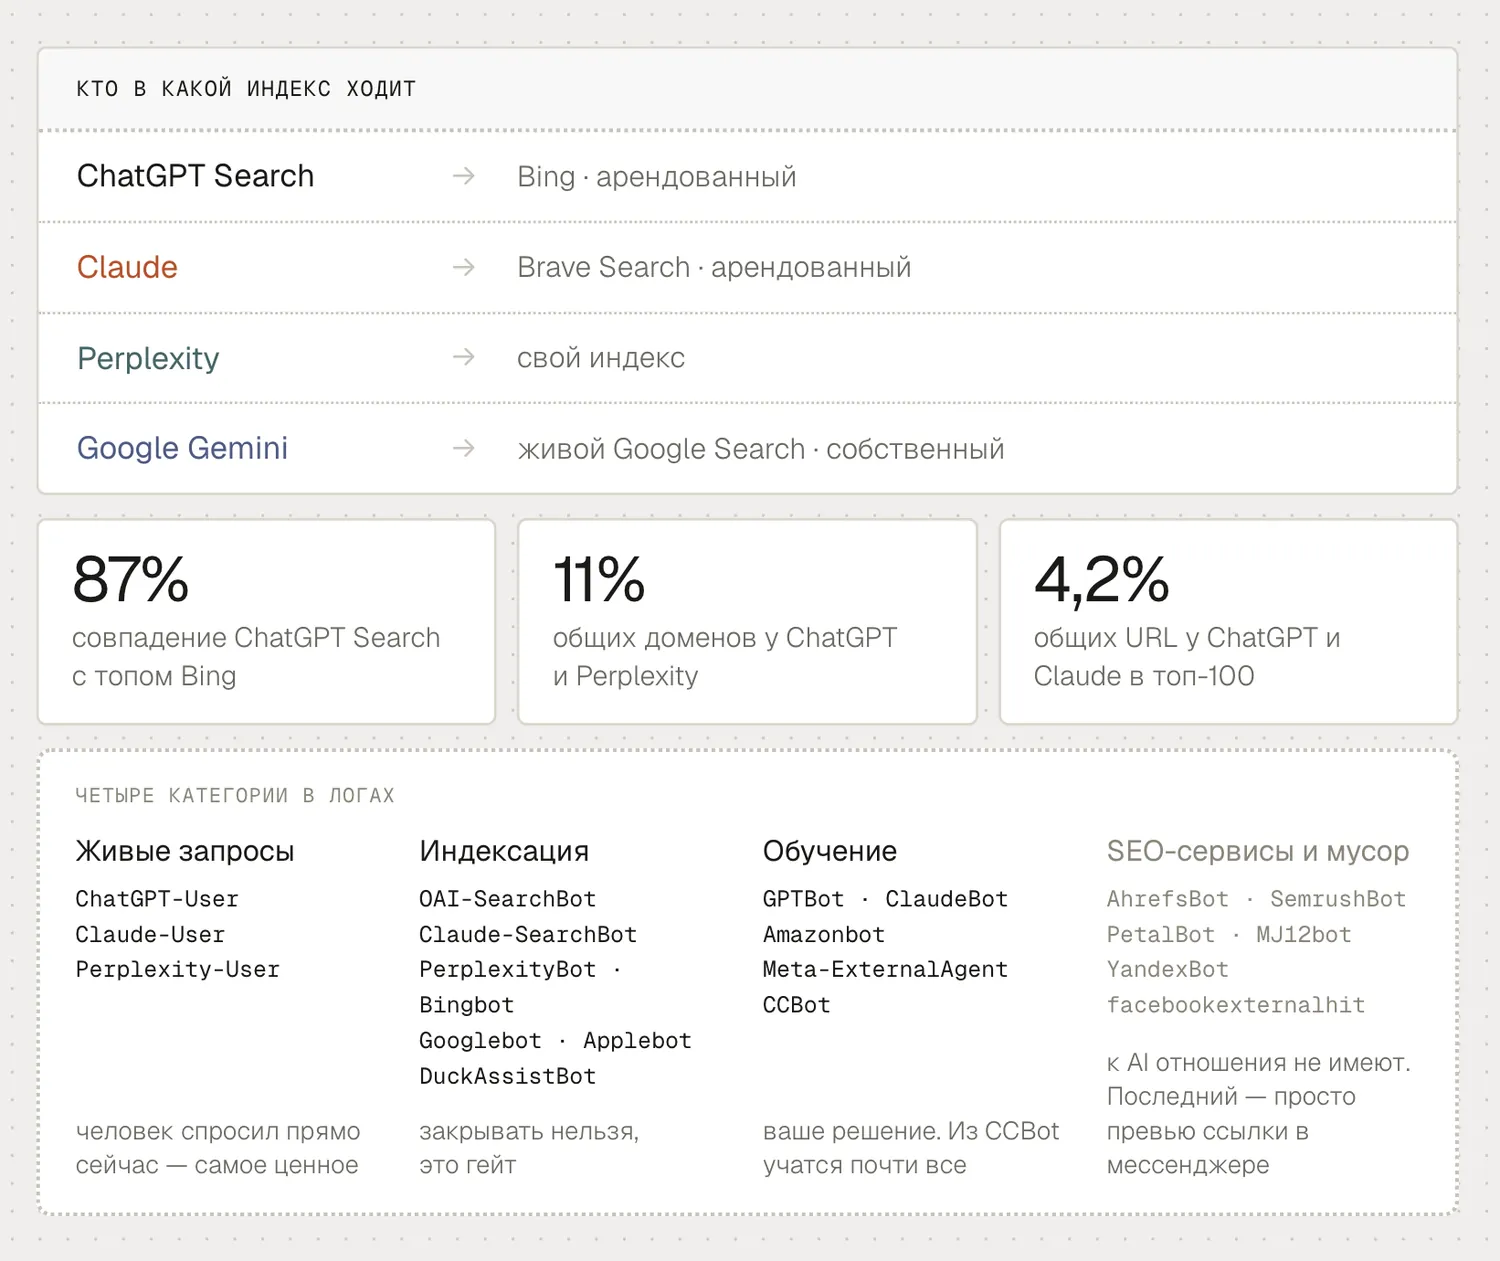
Таблица: ChatGPT Search ходит в арендованный Bing, Claude — в арендованный Brave, Perplexity — в собственный индекс, Gemini — в живой Google Search. Ниже — четыре категории ботов в логах сайта

часть 3 → 49 мин

Работы агентов в интернете по JTBD и инструменты

Работа агентов в открытом вебе через методику Jobs To Be Done: что агенты теперь делают в вебе и какие инструменты какие задачи уже решают. На атомы разбираем архитектуры новых инструментов — Exa, Parallel, Firecrawl, Newscatcher и Valyu, — чтобы с толком делегировать им задачи.

сборки

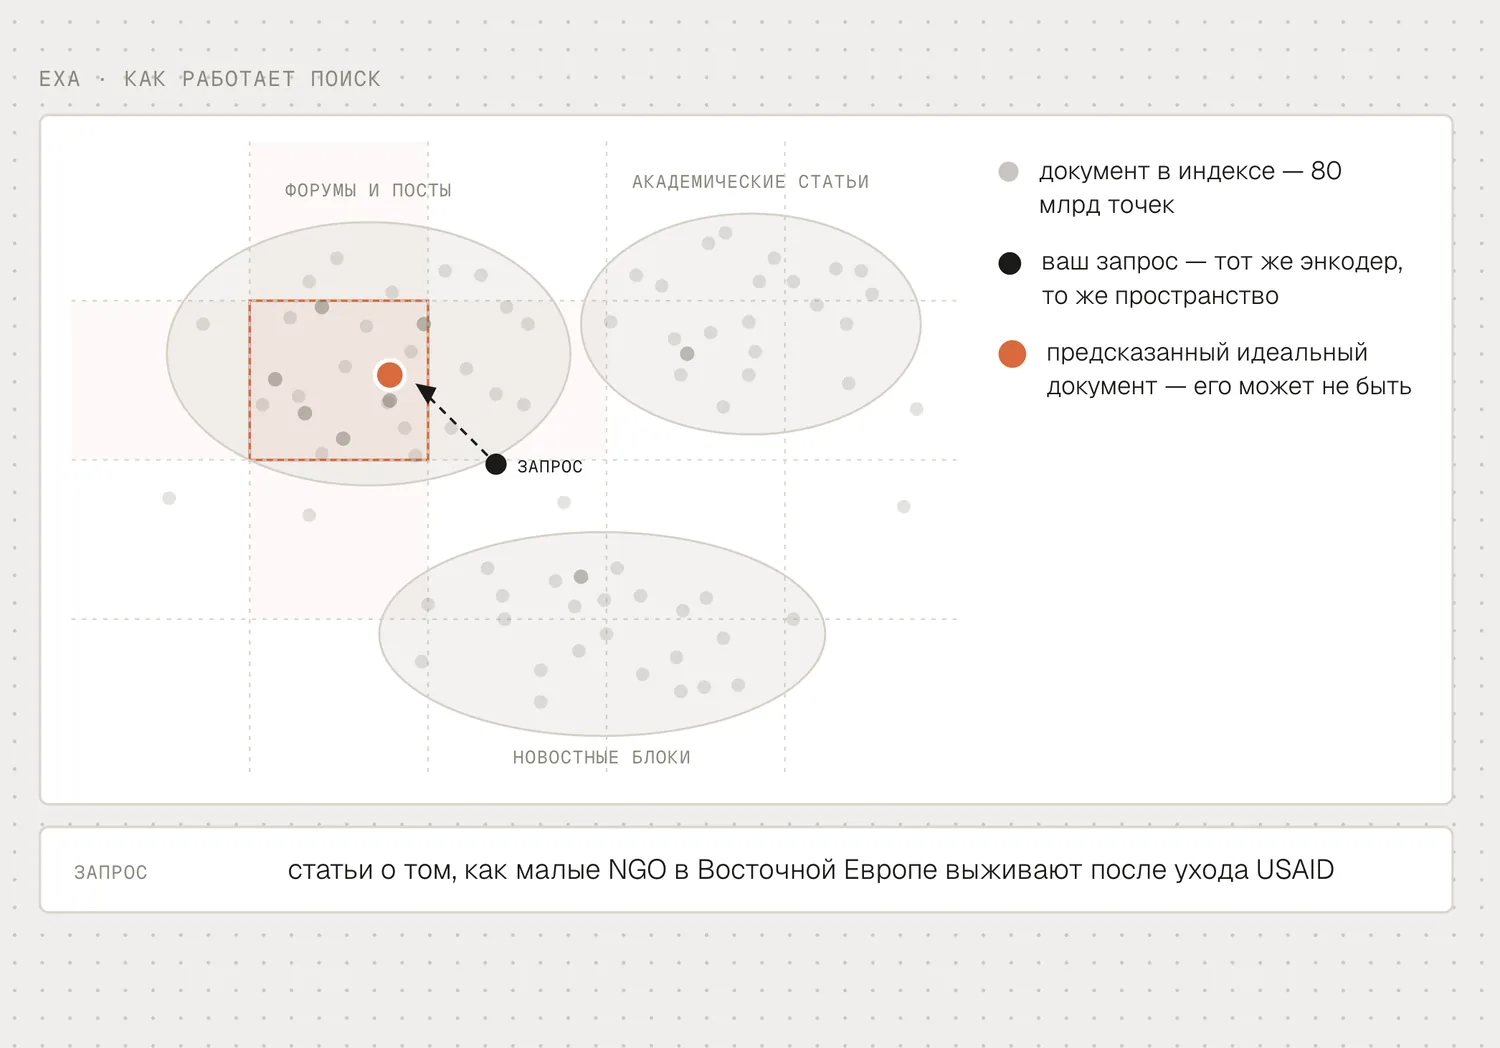
Схема поиска по смыслу: облака документов в общем пространстве, точка запроса и предсказанный идеальный документ рядом с ней

часть 4 → 33 мин

Сборки и агенты

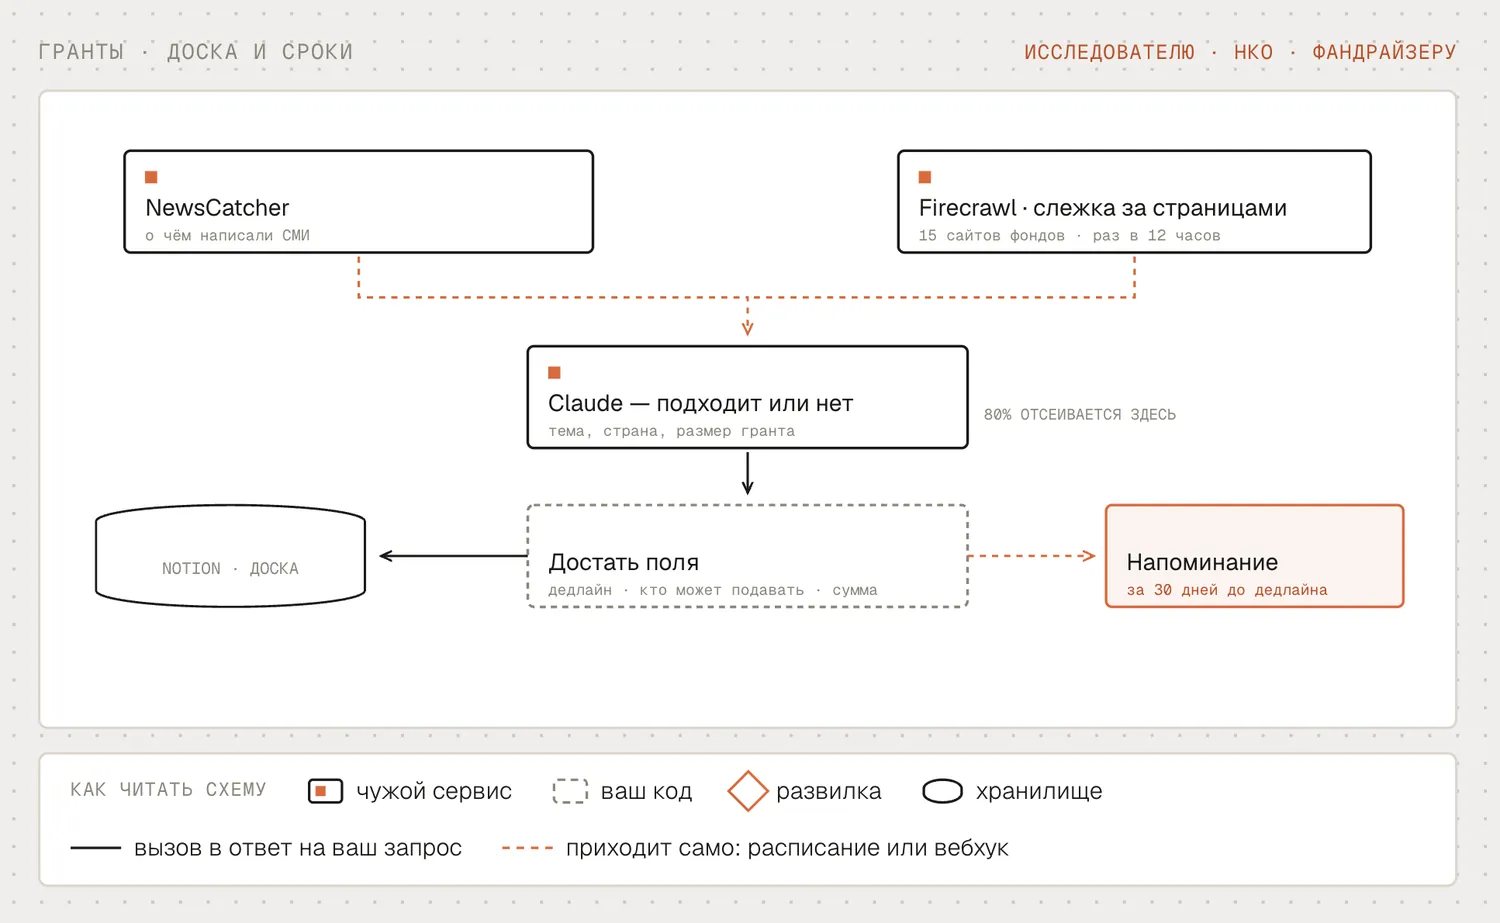
Тонкости самих сборок: workflows против агентских. Типовые сборки на живых примерах: дайджесты, B2B-поиск и обогащение данных, автоматика для подготовки к интервью и звонкам, поиск грантов и funding opportunities.

сборки

Схема сборки под поиск грантов с легендой: чужой сервис, свой код, развилка, хранилище; сплошные стрелки — вызов в ответ на запрос, пунктирные — расписание

часть 5 → 32 мин

API vs. MCP

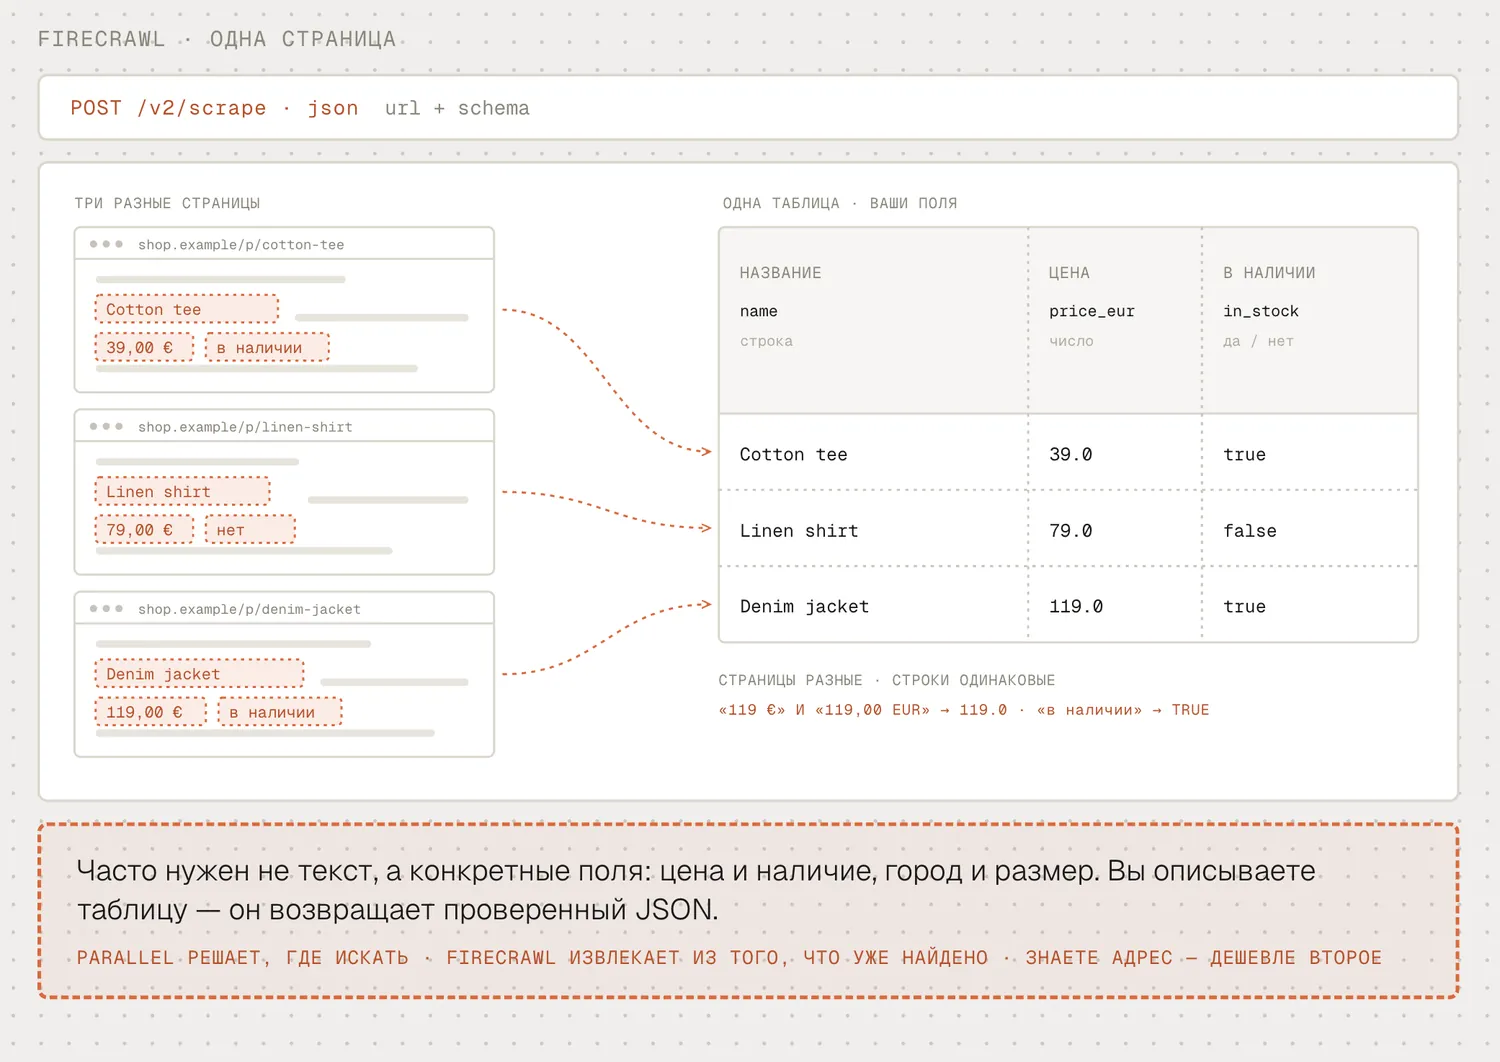
Разница подключения через API и через MCP — и почему ни в коем случае не нужно втыкать все MCP в мире.

сборки

Схема превращения веб-страницы в данные: три разных страницы магазина и одна таблица с полями «название», «цена», «в наличии», собранная по заданной схеме

часть 6 → 50 мин

Демо

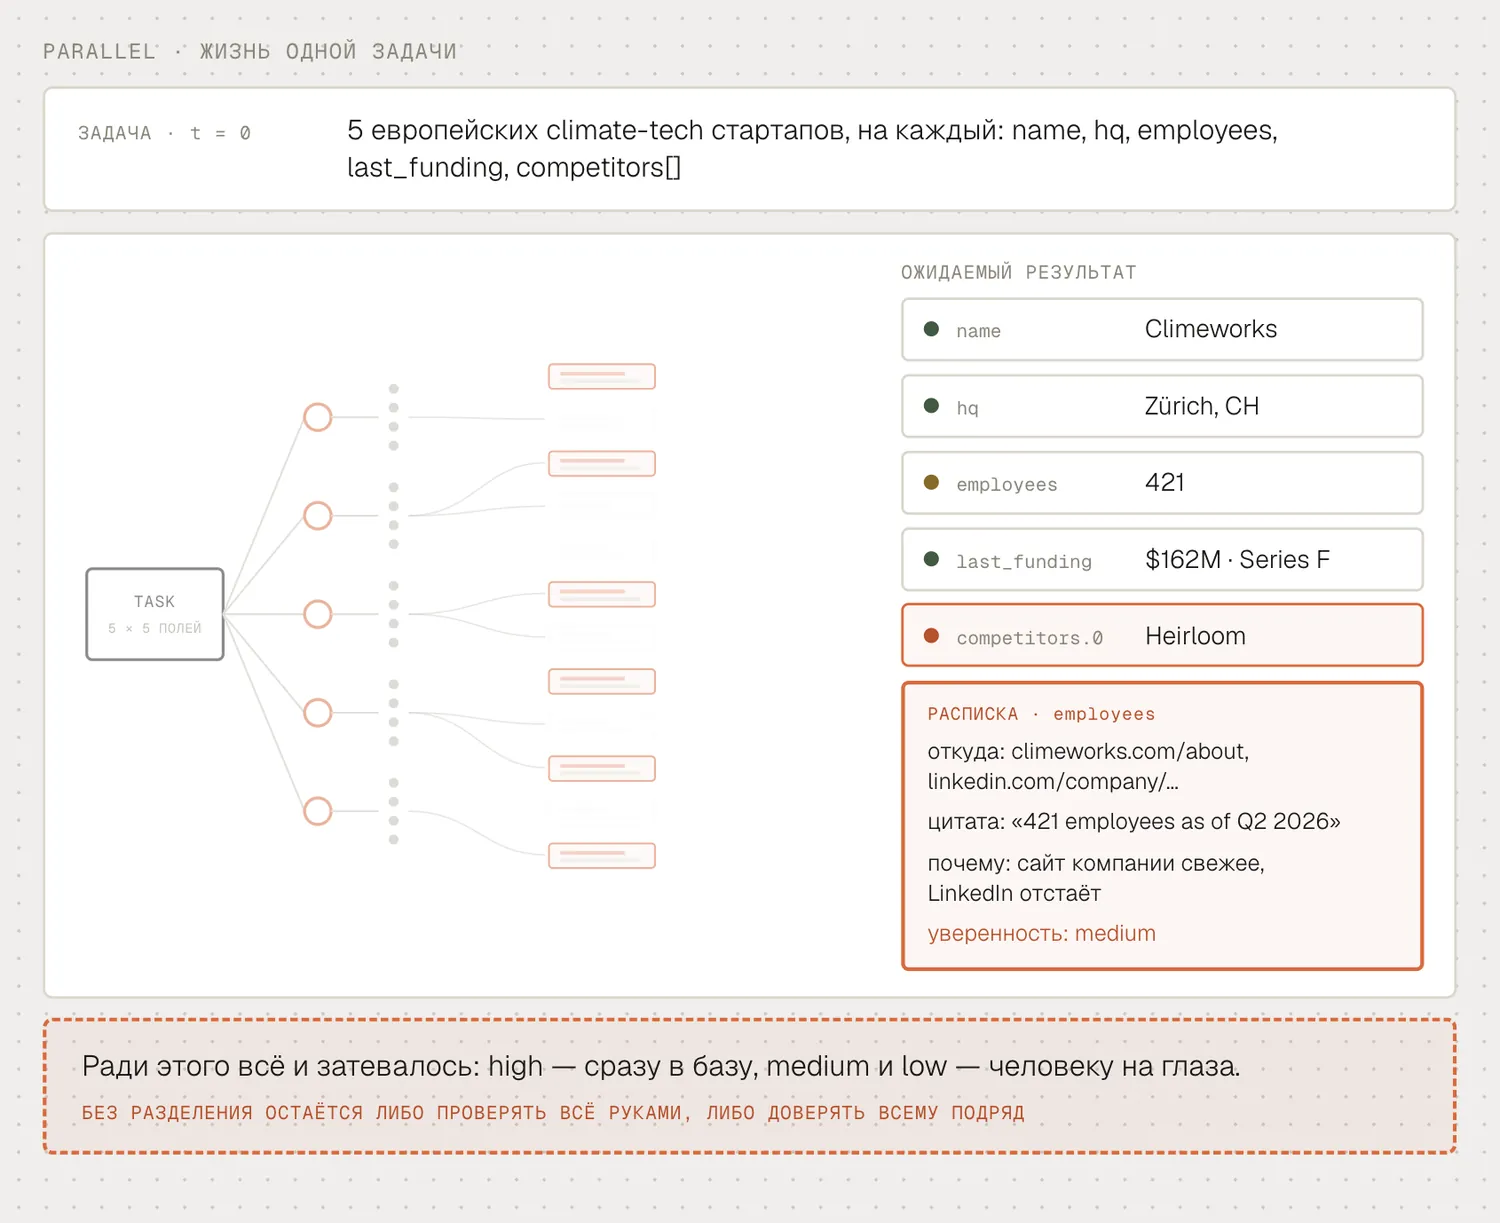
Одну и ту же задачу — мониторинг интернета — решаем тремя способами: чатом, пайплайном в n8n и агентом. На живом примере видно, чем они отличаются.

сборки

Схема выполнения одной задачи: запрос про пять климатических стартапов разветвляется на параллельные подзадачи и сходится в карточку компании с расписками, откуда взято каждое поле

часть 7 → 42 мин

SEO: что теперь измеряется и кто этим занимается

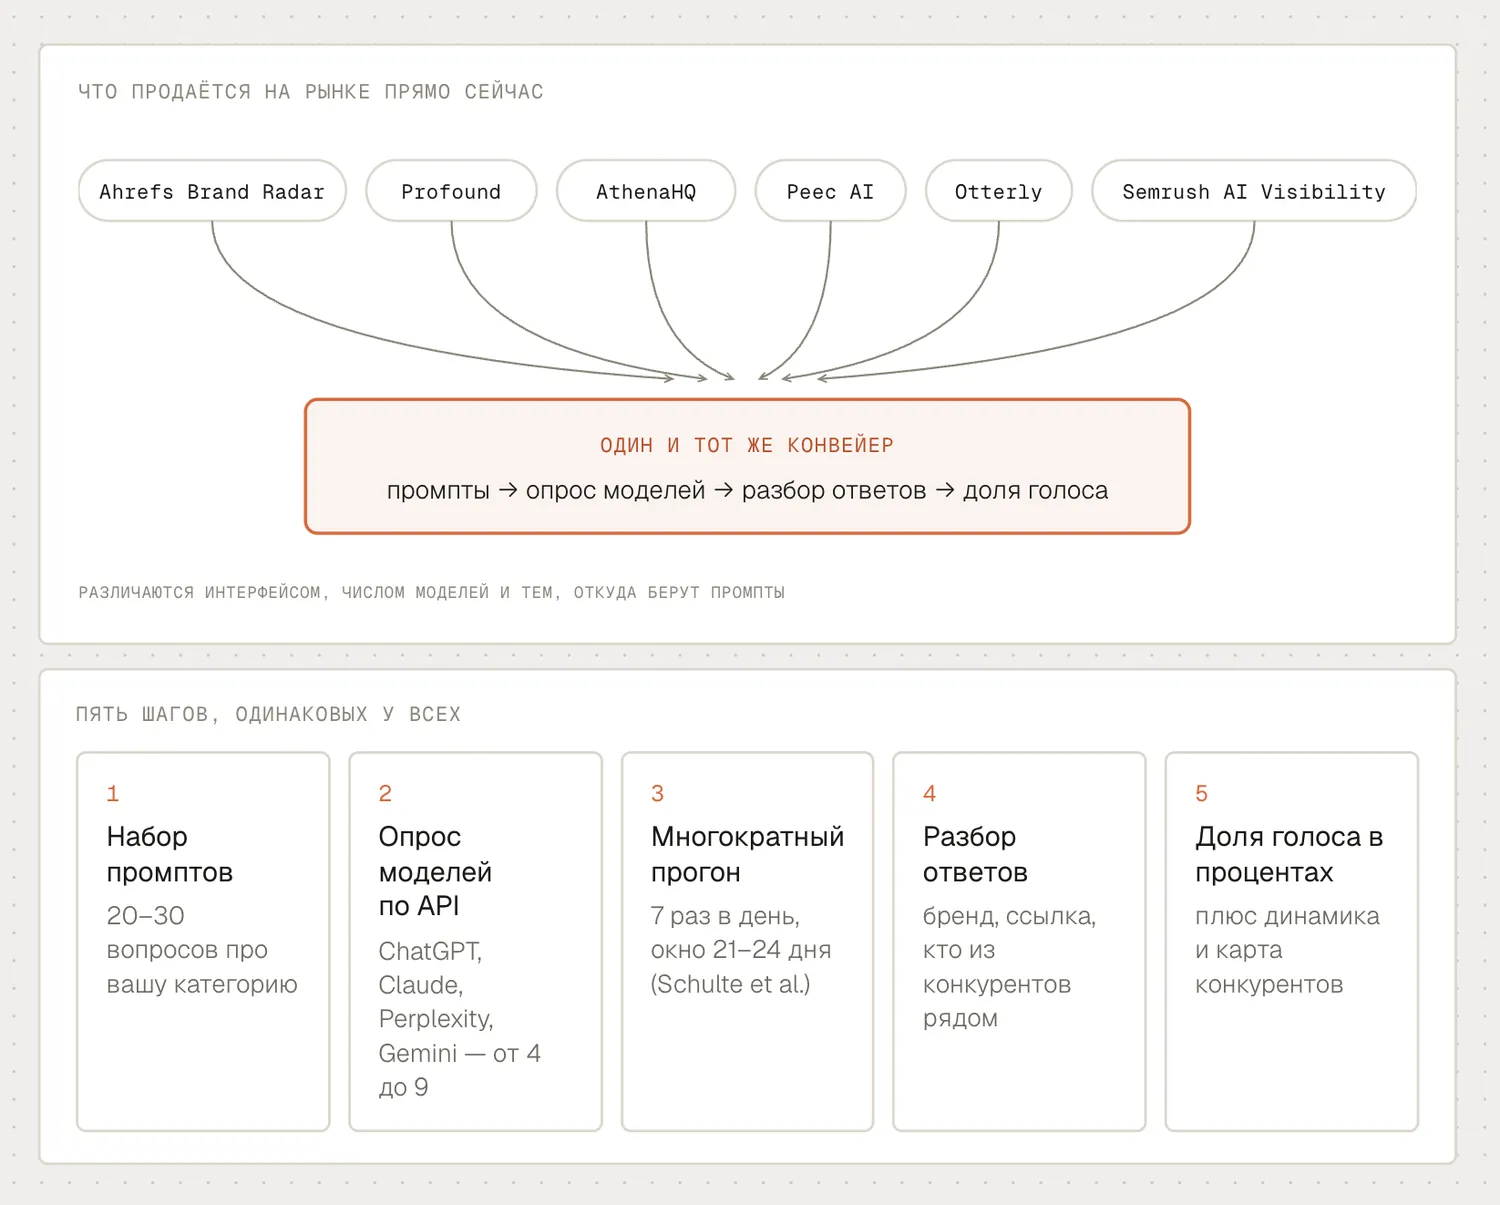
Что теперь можно измерять, во что превратилась профессия сеошника и на что смотреть, если вы работаете с SEO — сами или через подряд. Отдельный блок — как сейчас работают трекеры AI-visibility и что там принципиально можно и нельзя увидеть.

видимость

Схема рынка трекеров AI-видимости: шесть сервисов сводятся к одному конвейеру из пяти шагов — набор промптов, опрос моделей по API, многократный прогон, разбор ответов, доля голоса в процентах

FAQ

Чем треки отличаются друг от друга?

В курсе семь частей, и вместе они отвечают на два вопроса: как изменилась инфраструктура веба и что это значит для тех, кто ищет, и для тех, кто хочет, чтобы его находили.

Общая теоретическая часть — что именно изменилось в поиске — входит во все три трека. Дальше они расходятся.

«Инфраструктура и видимость» — про то, как вас находят: по сути весь разговор про SEO в новых условиях. Берите, если отвечаете за то, чтобы компанию находили.

«Инфраструктура и сборки» — части про инструменты, которыми ищут в интернете: чем они отличаются, как их подключать и как одну и ту же задачу решить чатом, пайплайном или агентом. Берите, если ищете и собираете сами.

Полный трек — и то и другое сразу. Первая часть открыта всем бесплатно.

Как долго курс доступен после покупки?

Курс доступен три месяца с момента покупки. Если вам нужно продлить доступ, напишите Ангелине в личные сообщения.

А если курс мне не понравится — можно вернуть деньги?

Напишите Ангелине в личные сообщения, и мы решим этот вопрос лично.

Есть вопрос по курсу?

Не уверены, что он вам подходит? Давайте обсудим — напишите Ангелине в личные сообщения.